
En bref
- La police toxique désigne un ensemble de techniques typographiques et textuelles conçues pour rendre certains contenus moins exploitables par les robots d’entraînement de l’intelligence artificielle.
- Le web subit une double pression : aspiration massive par les bots, chute du trafic humain vers les sites et multiplication du contenu synthétique de faible qualité.
- Ces contre-mesures relèvent autant de la cybersécurité que de l’éthique de l’IA, car elles posent la question du consentement, de la traçabilité et de la propriété des données.
- La fin de l’IA n’est pas le scénario le plus probable ; le basculement attendu concerne plutôt la fin de l’entraînement sauvage sur des données publiques non négociées.
Un éditeur indépendant fictif, l’Atelier Noria, publie chaque jour des analyses techniques, des enquêtes longues et des bases documentaires. Depuis deux ans, ses journaux serveur affichent une anomalie nette : moins de lecteurs venus des moteurs de recherche, mais davantage de robots qui aspirent les pages à cadence industrielle.
Face à cette pression, certains sites testent une riposte discrète : une police toxique, des caractères ambigus, des perturbations invisibles ou des fragments textuels destinés à dégrader la collecte automatisée. La question n’est plus seulement de savoir si l’IA peut lire le web, mais si le web acceptera encore de la nourrir gratuitement.
La police toxique des IA : une nouvelle arme défensive pour protéger le web
Le terme police toxique ne renvoie pas à une simple fantaisie graphique. Il désigne une famille de procédés qui restent lisibles pour l’œil humain, mais qui peuvent perturber les systèmes de collecte, d’OCR, de segmentation ou de normalisation utilisés avant l’entraînement des modèles génératifs.
Concrètement, un texte peut afficher une phrase normale à l’écran tout en contenant des ligatures, des homographes Unicode, des glyphes piégés ou des substitutions typographiques difficiles à interpréter proprement par une chaîne automatique. Pour un lecteur, la page reste fluide ; pour un robot, elle devient un matériau bruité, instable ou coûteux à exploiter.
Cette logique s’inscrit dans une tendance plus large : les créateurs, médias et plateformes cherchent à reprendre le contrôle de leurs données. Le phénomène est analysé dans plusieurs enquêtes sur les polices conçues pour empoisonner les modèles, qui décrivent une riposte technique à l’extraction massive.
L’enjeu central tient dans une asymétrie : les producteurs humains financent l’enquête, l’édition, la correction et l’hébergement, tandis que les grands systèmes automatisés capturent cette valeur pour la reconditionner. La typographie devient alors une couche de défense, comme le pare-feu l’a été pour les réseaux.
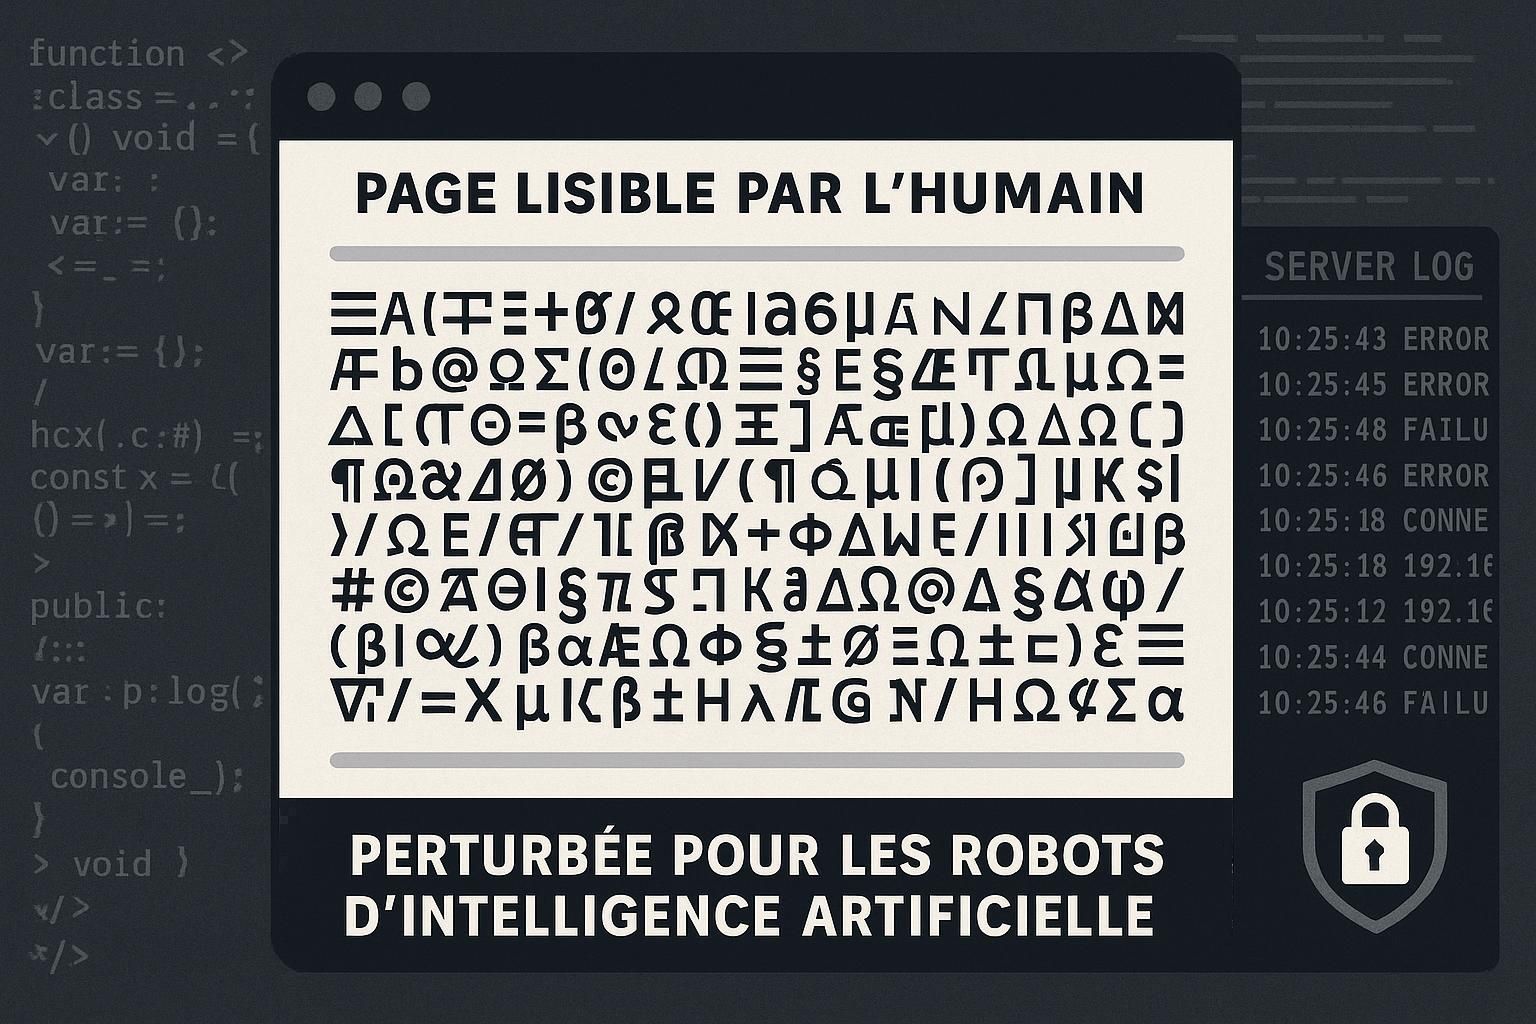
Comment une typographie piégée perturbe les modèles d’intelligence artificielle
Avant d’être intégrée à un grand modèle, une page passe par plusieurs filtres : extraction HTML, nettoyage, déduplication, reconnaissance des caractères, tokenisation et classement de qualité. C’est précisément dans ces étapes que la technologie de brouillage peut agir.
Une substitution subtile peut transformer un mot courant en séquence rare, augmenter artificiellement le bruit statistique ou casser les correspondances entre paragraphes. À grande échelle, ces anomalies réduisent la valeur d’un corpus, car le modèle apprend sur des chaînes moins cohérentes et plus difficiles à généraliser.
Chez l’Atelier Noria, le test est simple : les articles restent lisibles pour les abonnés, mais les versions servies à certains agents automatisés contiennent des marqueurs de provenance. Si un extrait réapparaît dans une réponse générée, l’équipe peut retracer l’origine probable de l’aspiration.
Cette approche ne détruit pas les systèmes génératifs, mais elle rend l’exploitation non consentie plus chère, plus risquée et moins fiable. L’insight technique est clair : la donnée publique n’est pas nécessairement une donnée libre d’usage industriel.
Le web assiégé par les robots de l’IA : pourquoi les sites durcissent leurs défenses
Les robots d’indexation existent depuis les débuts du web, et beaucoup remplissent encore une fonction légitime : référencer, archiver, détecter les liens morts ou surveiller la disponibilité. Le changement d’échelle vient des bots liés à l’intelligence artificielle, qui parcourent les sites non plus seulement pour les classer, mais pour absorber leurs contenus.
Des médias et administrateurs décrivent des pics de requêtes qui ralentissent les serveurs, augmentent les coûts d’infrastructure et dégradent l’expérience des visiteurs. Cette bataille autour de l’aspiration du web est documentée dans une enquête du Monde sur les bots qui aspirent les sites.
Le problème devient économique quand les réponses générées remplacent le clic. Un internaute obtient une synthèse directement dans un moteur ou un assistant, sans visiter la source qui a produit l’information. À long terme, l’Atelier Noria finance donc des contenus que d’autres systèmes résument, concurrencent et monétisent indirectement.
Cette tension explique l’apparition de nouvelles défenses : blocage par fichier robots.txt, listes d’agents interdits, limitation de débit, empreintes comportementales, captchas sélectifs, licences de données et, désormais, brouillage typographique. Le web n’est pas fermé ; il devient négociateur.
Slop, chute du trafic et boucle de recyclage : le risque d’un internet synthétique
Le mot slop décrit cette masse de contenus générés automatiquement, souvent optimisés pour capter l’attention mais pauvres en vérification, en style et en expertise. Lorsque ces pages sont ensuite réaspirées pour entraîner de nouveaux modèles, une boucle se forme : la machine apprend de plus en plus sur des sorties de machine.
Cette boucle peut amplifier un biais algorithmique, appauvrir la diversité des sources et rendre les erreurs plus difficiles à isoler. Une statistique inventée, un faux auteur ou une explication simplifiée peut se propager d’un site à l’autre, jusqu’à paraître fiable par simple répétition.
Plusieurs analyses évoquent cette détérioration progressive, notamment l’idée que l’IA transforme la toile en base de contenus recyclés. La formule est brutale, mais elle pointe un mécanisme réel : si l’original disparaît derrière la synthèse, la chaîne de valeur éditoriale se fragilise.
Le documentaire consacré au slop et à la dégradation du réseau illustre aussi cette inquiétude, en montrant comment plateformes sociales, moteurs et fermes de contenus se renforcent mutuellement. Le web, qui devait être une bibliothèque ouverte, risque de devenir un miroir qui se copie lui-même.
Cybersécurité, surveillance et éthique de l’IA : où placer la limite de la riposte ?
La cybersécurité défensive vise à protéger un système, un contenu ou une infrastructure. Mais lorsqu’un site sert volontairement des données piégées, la frontière devient plus délicate : s’agit-il d’un contrôle d’accès, d’un filigrane, d’une contre-mesure ou d’un sabotage de corpus ?
Sur le plan juridique et opérationnel, la réponse dépend du contexte. Une police qui signale la provenance d’un texte ou dégrade la collecte non autorisée peut être vue comme une protection de propriété intellectuelle. Une charge conçue pour endommager un système tiers entrerait, elle, dans une logique beaucoup plus risquée.
L’éthique de l’IA impose ici une question simple : les modèles doivent-ils pouvoir apprendre sur tout ce qui est techniquement accessible ? Si un atelier, un média ou une chercheuse publie en ligne, cela ne signifie pas forcément qu’ils consentent à l’intégration de leur travail dans un produit commercial opaque.
La surveillance ajoute une couche supplémentaire. Pour bloquer les robots, les sites doivent analyser les comportements, identifier les agents, comparer les signatures réseau et parfois profiler les requêtes. Défendre le contenu ne doit pas se transformer en collecte excessive de données sur les lecteurs humains.
Les garde-fous techniques pour éviter une guerre totale entre sites et modèles
Une stratégie robuste ne repose pas sur une seule barrière. Elle combine des règles explicites, des contrôles techniques et des accords contractuels, afin de distinguer recherche légitime, indexation utile et extraction industrielle massive.
- Déclaration claire des droits d’usage : licences lisibles, métadonnées de consentement et conditions de réutilisation intégrées aux pages.
- Contrôle des robots : limitation de débit, filtrage des agents agressifs, journalisation des pics anormaux et vérification des identités déclarées.
- Marquage des contenus : filigranes textuels, empreintes statistiques, typographies défensives et détection des reprises non autorisées.
- Accords de données : accès payant, API contrôlée, corpus certifiés et traçabilité des sources utilisées pour l’entraînement.
- Audit des biais : évaluation des corpus pour réduire le biais algorithmique, les duplications et les contenus synthétiques contaminés.
Pour l’Atelier Noria, cette combinaison offre un compromis : préserver l’accès des lecteurs, autoriser les usages de recherche correctement encadrés et bloquer les collectes qui dégradent l’infrastructure. La défense efficace n’est pas la fermeture brutale, mais la granularité.
La fin de l’IA ou la fin de l’entraînement gratuit sur le web ouvert ?
Parler de fin de l’IA est spectaculaire, mais techniquement réducteur. Les grands modèles ne vont pas disparaître parce que des sites utilisent une police toxique ; ils vont devoir s’adapter à un environnement moins permissif, plus contractuel et plus traçable.
Le scénario le plus crédible est une mutation des chaînes d’approvisionnement en données. Les entreprises privilégieront des corpus sous licence, des partenariats avec éditeurs, des données synthétiques validées, des bases internes et des mécanismes de provenance cryptographique.
Cette évolution est déjà visible dans les débats sur le web assiégé par les robots de l’IA et sur la manière dont l’intelligence artificielle remodèle Internet. La tension ne porte plus seulement sur l’innovation, mais sur la soutenabilité de l’écosystème qui la nourrit.
Pour les modèles eux-mêmes, le risque majeur n’est pas l’empoisonnement ponctuel, mais la perte de confiance dans les données. Un corpus mal sourcé, contaminé par du slop ou truffé de pièges invisibles devient coûteux à nettoyer et difficile à certifier.
Ce que les éditeurs, développeurs et plateformes doivent surveiller maintenant
Les éditeurs doivent suivre leurs journaux serveur avec la même rigueur qu’un administrateur suit une attaque par déni de service. Un robot trop agressif peut consommer de la bande passante, provoquer des latences et augmenter la facture cloud sans jamais apporter de lecteur réel.
Les développeurs de modèles ont, eux, intérêt à documenter la provenance des corpus. Plus une base est transparente, plus elle devient défendable face aux critiques de plagiat, de biais algorithmique ou de captation non consentie.
Les plateformes intermédiaires devront arbitrer entre visibilité et protection. Si elles favorisent seulement les réponses générées, elles assèchent les sites sources ; si elles rémunèrent, citent et redirigent correctement, elles maintiennent la production humaine dont dépend tout l’écosystème.
La police toxique agit donc comme un symptôme autant qu’un outil. Elle signale que le contrat historique du web ouvert est rompu : lire n’est pas aspirer, indexer n’est pas entraîner, et innover ne dispense pas de négocier l’accès à la matière première informationnelle.